西门子 PLC 通讯(一):数据在 DB 块里怎么存
2022 年 6 月 23 日 · 3 分钟读完
研究上位机通讯时派生出来的支线:用 S7 协议读 PLC,本质上是「从 DB10 的第 26 个字节开始读 n 个字节」,读回来的是一串原始字节,怎么解释全靠自己。所以要先搞清楚每种类型在 DB 块里的样子。
先关掉「优化的块访问」
S7-1200 / 1500 新建的 DB 块默认勾选了优化的块访问,这时变量没有固定的偏移地址(DB 编辑器里看不到「偏移量」一列),PLC 自己安排存储位置,外部只能按符号名访问(OPC UA 之类)。
S7.Net 这类走 PUT/GET 的库只能按绝对地址读写,所以要:DB 块右键 → 属性 → 常规 → 属性 → 取消勾选「优化的块访问」,然后编译。之后 DB 编辑器里会出现「偏移量」一列,下面说的地址都以它为准。
String
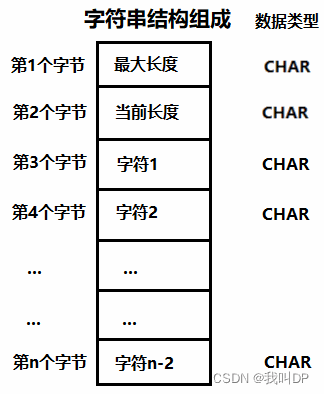
S7-300 / 400 / 1200 / 1500 里,String 其实是一个字符数组,前面加两个字节的头:
| 字节 | 内容 |
|---|---|
| 0 | 最大长度(声明时的长度,默认 254) |
| 1 | 当前实际长度 |
| 2 ~ | 字符,每个 1 字节 |
头部占了 2 字节,整个 String 最多 256 字节,所以字符最多 254 个。
声明两个变量看看偏移:
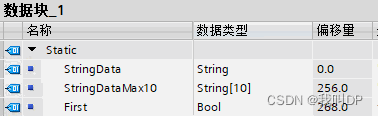
String:默认长度 254,占 256 字节(偏移 0 ~ 255,下一个变量从 256 开始);String[10]:长度 10,占 12 字节(偏移 256 ~ 267,下一个从 268 开始)。
所以读一个 String,正确的做法是先读第 1 个字节拿到实际长度 n,再从第 2 个字节开始读 n 个字节。直接读满 254 个字节,后面会带上上次留下的旧字符。
String 里的字符按单字节处理,写中文会乱码,要中文就用 WString。
WString
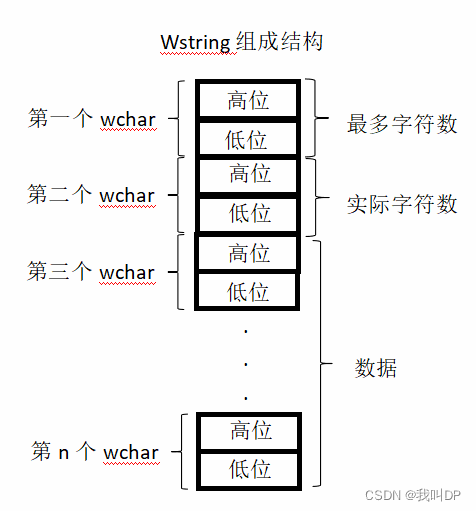
WString 是宽字符(WChar)数组,每个字符 2 字节,用 UTF-16 编码,可以存中文。结构和 String 类似,只是每一项都变成了 2 字节:
| 字节 | 内容 |
|---|---|
| 0 ~ 1 | 最大长度(WChar 的个数,不是字节数) |
| 2 ~ 3 | 当前实际长度(WChar 的个数) |
| 4 ~ | 字符,每个 2 字节 |
声明两个变量看看偏移:
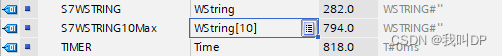
WString:默认长度 254 个字符,占 254 × 2 + 2 × 2 = 512 字节(偏移 282 ~ 793,下一个从 794 开始);WString[10]:长度 10,占 10 × 2 + 2 × 2 = 24 字节(偏移 794 ~ 817)。
长度最大可以声明到 16382。
举例:存「哇哈」
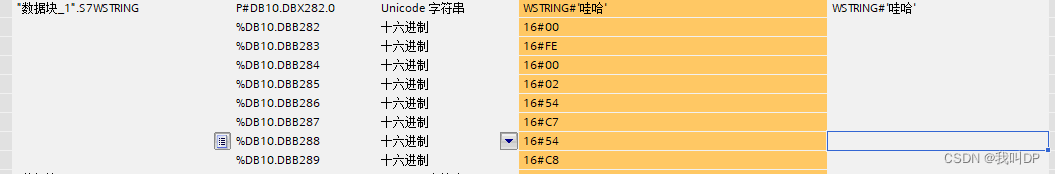
| 最大长度 | 实际长度 | 哇 | 哈 | |
|---|---|---|---|---|
| 值 | 254 | 2 | U+54C7 | U+54C8 |
| 内存里的字节 | 00 FE |
00 02 |
54 C7 |
54 C8 |
西门子 PLC 是大端存储:数据的高位放在低地址。比如最大长度 254(0x00FE),高位 00 在 DBB282,低位 FE 在 DBB283。字符也一样,「哇」的 54 在前、C7 在后。
C# 的 Encoding.Unicode 是小端,会得到 C7 54,所以和 PLC 交换 WString 时必须用 Encoding.BigEndianUnicode。编码的细节见 字符编码:ASCII、GBK 与 Unicode。
其他常用类型
| 类型 | 字节数 | 说明 | 地址写法 |
|---|---|---|---|
| Bool | 1 位 | 8 个 Bool 共用一个字节 | DB10.DBX0.0 ~ DBX0.7 |
| Byte | 1 | 无符号 0 ~ 255 | DB10.DBB1 |
| Word | 2 | 无符号 16 位 | DB10.DBW2 |
| Int | 2 | 有符号 16 位 | DB10.DBW8 |
| DWord | 4 | 无符号 32 位 | DB10.DBD4 |
| DInt | 4 | 有符号 32 位 | DB10.DBD10 |
| Real | 4 | IEEE 754 单精度 | DB10.DBD14 |
| LReal | 8 | IEEE 754 双精度(仅 1200 / 1500) | 没有 8 字节的地址写法,按字节读 |
| Char / WChar | 1 / 2 | 单个字符 |
几个容易踩的点:
- 大端字节序:西门子 PLC 是大端(高字节在前),x86 的 PC 是小端。Int 100 在 PLC 里是
00 64,PC 上直接BitConverter.ToInt16会得到0x6400= 25600。S7.Net 内部已经帮你翻转了,自己解析原始字节时要注意。 - Word 和 Int 是同样的 2 个字节,区别只在怎么解释最高位:
FF FF当 Word 是 65535,当 Int 是 -1。原理见 原码、反码和补码。 - Real 是浮点数:4 个字节按 IEEE 754 解释,不能当成整数读。见 浮点数是怎么存的。
- 偶数对齐:非优化 DB 里,Bool 和 Byte 之后的 Word / Int / Real 等会从偶数字节开始,中间会空出一个字节。所以地址一定以 DB 编辑器里的「偏移量」为准,不要自己累加。
延伸
- Struct 和数组:Struct 内部按上面的规则依次排列,整体也从偶数字节开始;Bool 数组按位紧密排列。要批量读一整段,可以按偏移一次读出一大块字节,再在 C# 里按偏移切开解析,比一个一个变量读快得多(每次读写都是一次网络往返)。
- S7.Net 的
ReadClass/ReadStruct:定义一个字段顺序、类型和 DB 完全一致的 C# 类,可以一次读出整个 DB。字段对不齐时会错位,所以前提是 DB 结构稳定,而且不含 String。 - 时间类型:
Time是 4 字节的毫秒数(DInt);Date是 2 字节,表示从 1990-01-01 起的天数;DTL是 12 字节的结构体(年 2 字节,月、日、星期、时、分、秒各 1 字节,纳秒 4 字节)。
下一篇:没有真 PLC 时,怎么用 PLCSIM Advanced 仿真一台 1500。
原文首发于 blog.csdn.net