字符编码:ASCII、GBK 与 Unicode
2022 年 7 月 4 日 · 3 分钟读完
经常遇到编码问题绕来绕去,决定好好学一遍。
字符、字符集、编码方式
- 字符:抽象的最小文本单位,只代表一个符号,没有固定的值。「A」「€」「中」都是字符。
- 字符集:符号和数字的对应表。它规定了 21475(十六进制 53E3)是「口」。ASCII、GB2312、Unicode 都是字符集。
- 编码方式:同样是 21475 这个数,存成
口还是%E5%8F%A3(UTF-8 的三个字节),由编码方式决定。UTF-8 是编码方式,不是字符集。
常见字符集
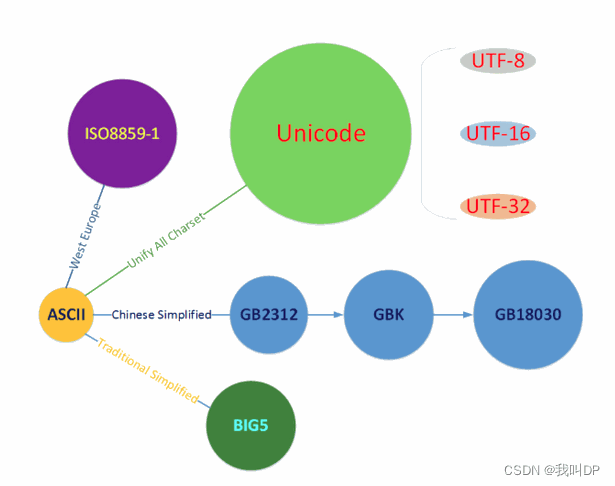
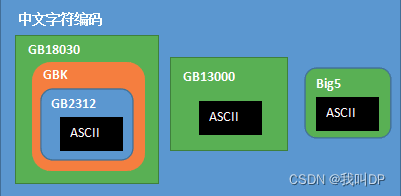
中文字符集的包含关系:
| 字符集 | 用途 | 长度 | 范围或容量 |
|---|---|---|---|
| ASCII | 英文 | 7 位,128 个字符 | 00 ~ 7F |
| 扩展 ASCII | 西欧语言 | 8 位,256 个字符 | 00 ~ FF |
| ISO-8859-1 | 西欧、希腊语等,兼容 ASCII | 8 位 | 00 ~ FF |
| GB2312 | 简体中文,兼容 ASCII | 2 字节 | 7445 个符号,含 6763 个汉字,高低字节都在 A1 ~ FE |
| BIG5 | 繁体中文 | 2 字节 | 13053 个汉字 |
| GBK | GB2312 的扩展,加入繁体 | 2 字节 | 21886 个字符,高字节 81 ~ FE,低字节 40 ~ FE |
| GB18030 | 兼容 GBK,覆盖少数民族文字、日文、韩文 | 1、2、4 字节变长 | 可以表示全部 Unicode 字符 |
| Unicode | 全世界的文字统一编号 | 由 UTF-8/16/32 决定 | 0 ~ 10FFFF,约 111 万个码位 |
Unicode 的三种编码方式
UTF-32
固定 4 个字节,直接存 Unicode 编号,不需要转换。省事但费空间。
UTF-16
最初用 2 个字节,例如「我」的编号是 25105(6211),UTF-16 存成 0110 0010 0001 0001。
2 个字节最多到 FFFF,不够覆盖到 10FFFF,所以超出的部分用 4 个字节(代理对):
| 编号范围 | 编号的二进制 | UTF-16 | 字节数 |
|---|---|---|---|
| 0000 ~ FFFF | xxxx xxxx xxxx xxxx | xxxx xxxx xxxx xxxx | 2 |
| 1 0000 ~ 10 FFFF | 先减去 1 0000,剩 20 位 yyyy yyyy yyxx xxxx xxxx | 110110yy yyyyyyyy 110111xx xxxxxxxx | 4 |
以 110110 开头的是高位代理,以 110111 开头的是低位代理。为了不和 2 字节的字符冲突,D800 ~ DFFF 这一段在 Unicode 里专门空出来,不分配给任何字符。
UTF-8
UTF-16 不兼容 ASCII,英文也要占 2 个字节,很浪费。于是有了 1 ~ 4 字节变长的 UTF-8:
| 编号范围 | UTF-8 字节格式 | 有效位数 | 字节数 |
|---|---|---|---|
| 0 ~ 7F | 0xxx xxxx | 7 | 1 |
| 80 ~ 7FF | 110x xxxx 10xx xxxx | 11 | 2 |
| 800 ~ FFFF | 1110 xxxx 10xx xxxx 10xx xxxx | 16 | 3 |
| 1 0000 ~ 10 FFFF | 1111 0xxx 10xx xxxx 10xx xxxx 10xx xxxx | 21 | 4 |
「我」= 6211 = 0110 0010 0001 0001,落在第三行,把 16 位依次填进 1110 xxxx 10xx xxxx 10xx xxxx:
1110 0110 1000 1000 1001 0001 = E6 88 91所以常用汉字在 UTF-8 里占 3 个字节,在 GBK 里占 2 个字节。
字节序:大端和小端
UTF-16、UTF-32 一个字符占多个字节,哪个字节在前?这就是字节序。
值 0x12345678         低地址 → 高地址
大端(Big-Endian):    12 34 56 78    高位字节放在低地址
小端(Little-Endian): 78 56 34 12    低位字节放在低地址
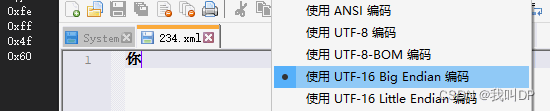
在记事本里输入「你」(4F60),存成 UTF-16 小端,60 在前:
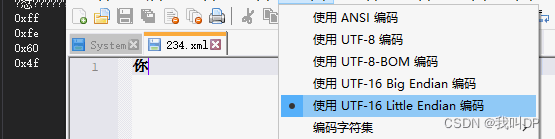
改成大端,4F 在前:
怎么认出文件的编码:BOM
Unicode 文件可以在开头放几个字节标明编码,叫 BOM(Byte Order Mark):
| 编码 | BOM |
|---|---|
| UTF-8 | EF BB BF(可有可无) |
| UTF-16 大端 | FE FF |
| UTF-16 小端 | FF FE |
| UTF-32 大端 | 00 00 FE FF |
| UTF-32 小端 | FF FE 00 00 |
GB2312、GBK 没有 BOM,只能靠特征猜:GB2312 一个汉字的高低字节最高位都是 1;GBK 只保证高字节最高位是 1。最高位是 0 的就是 ASCII。
ASCII 码表
来源:菜鸟教程 ASCII 表
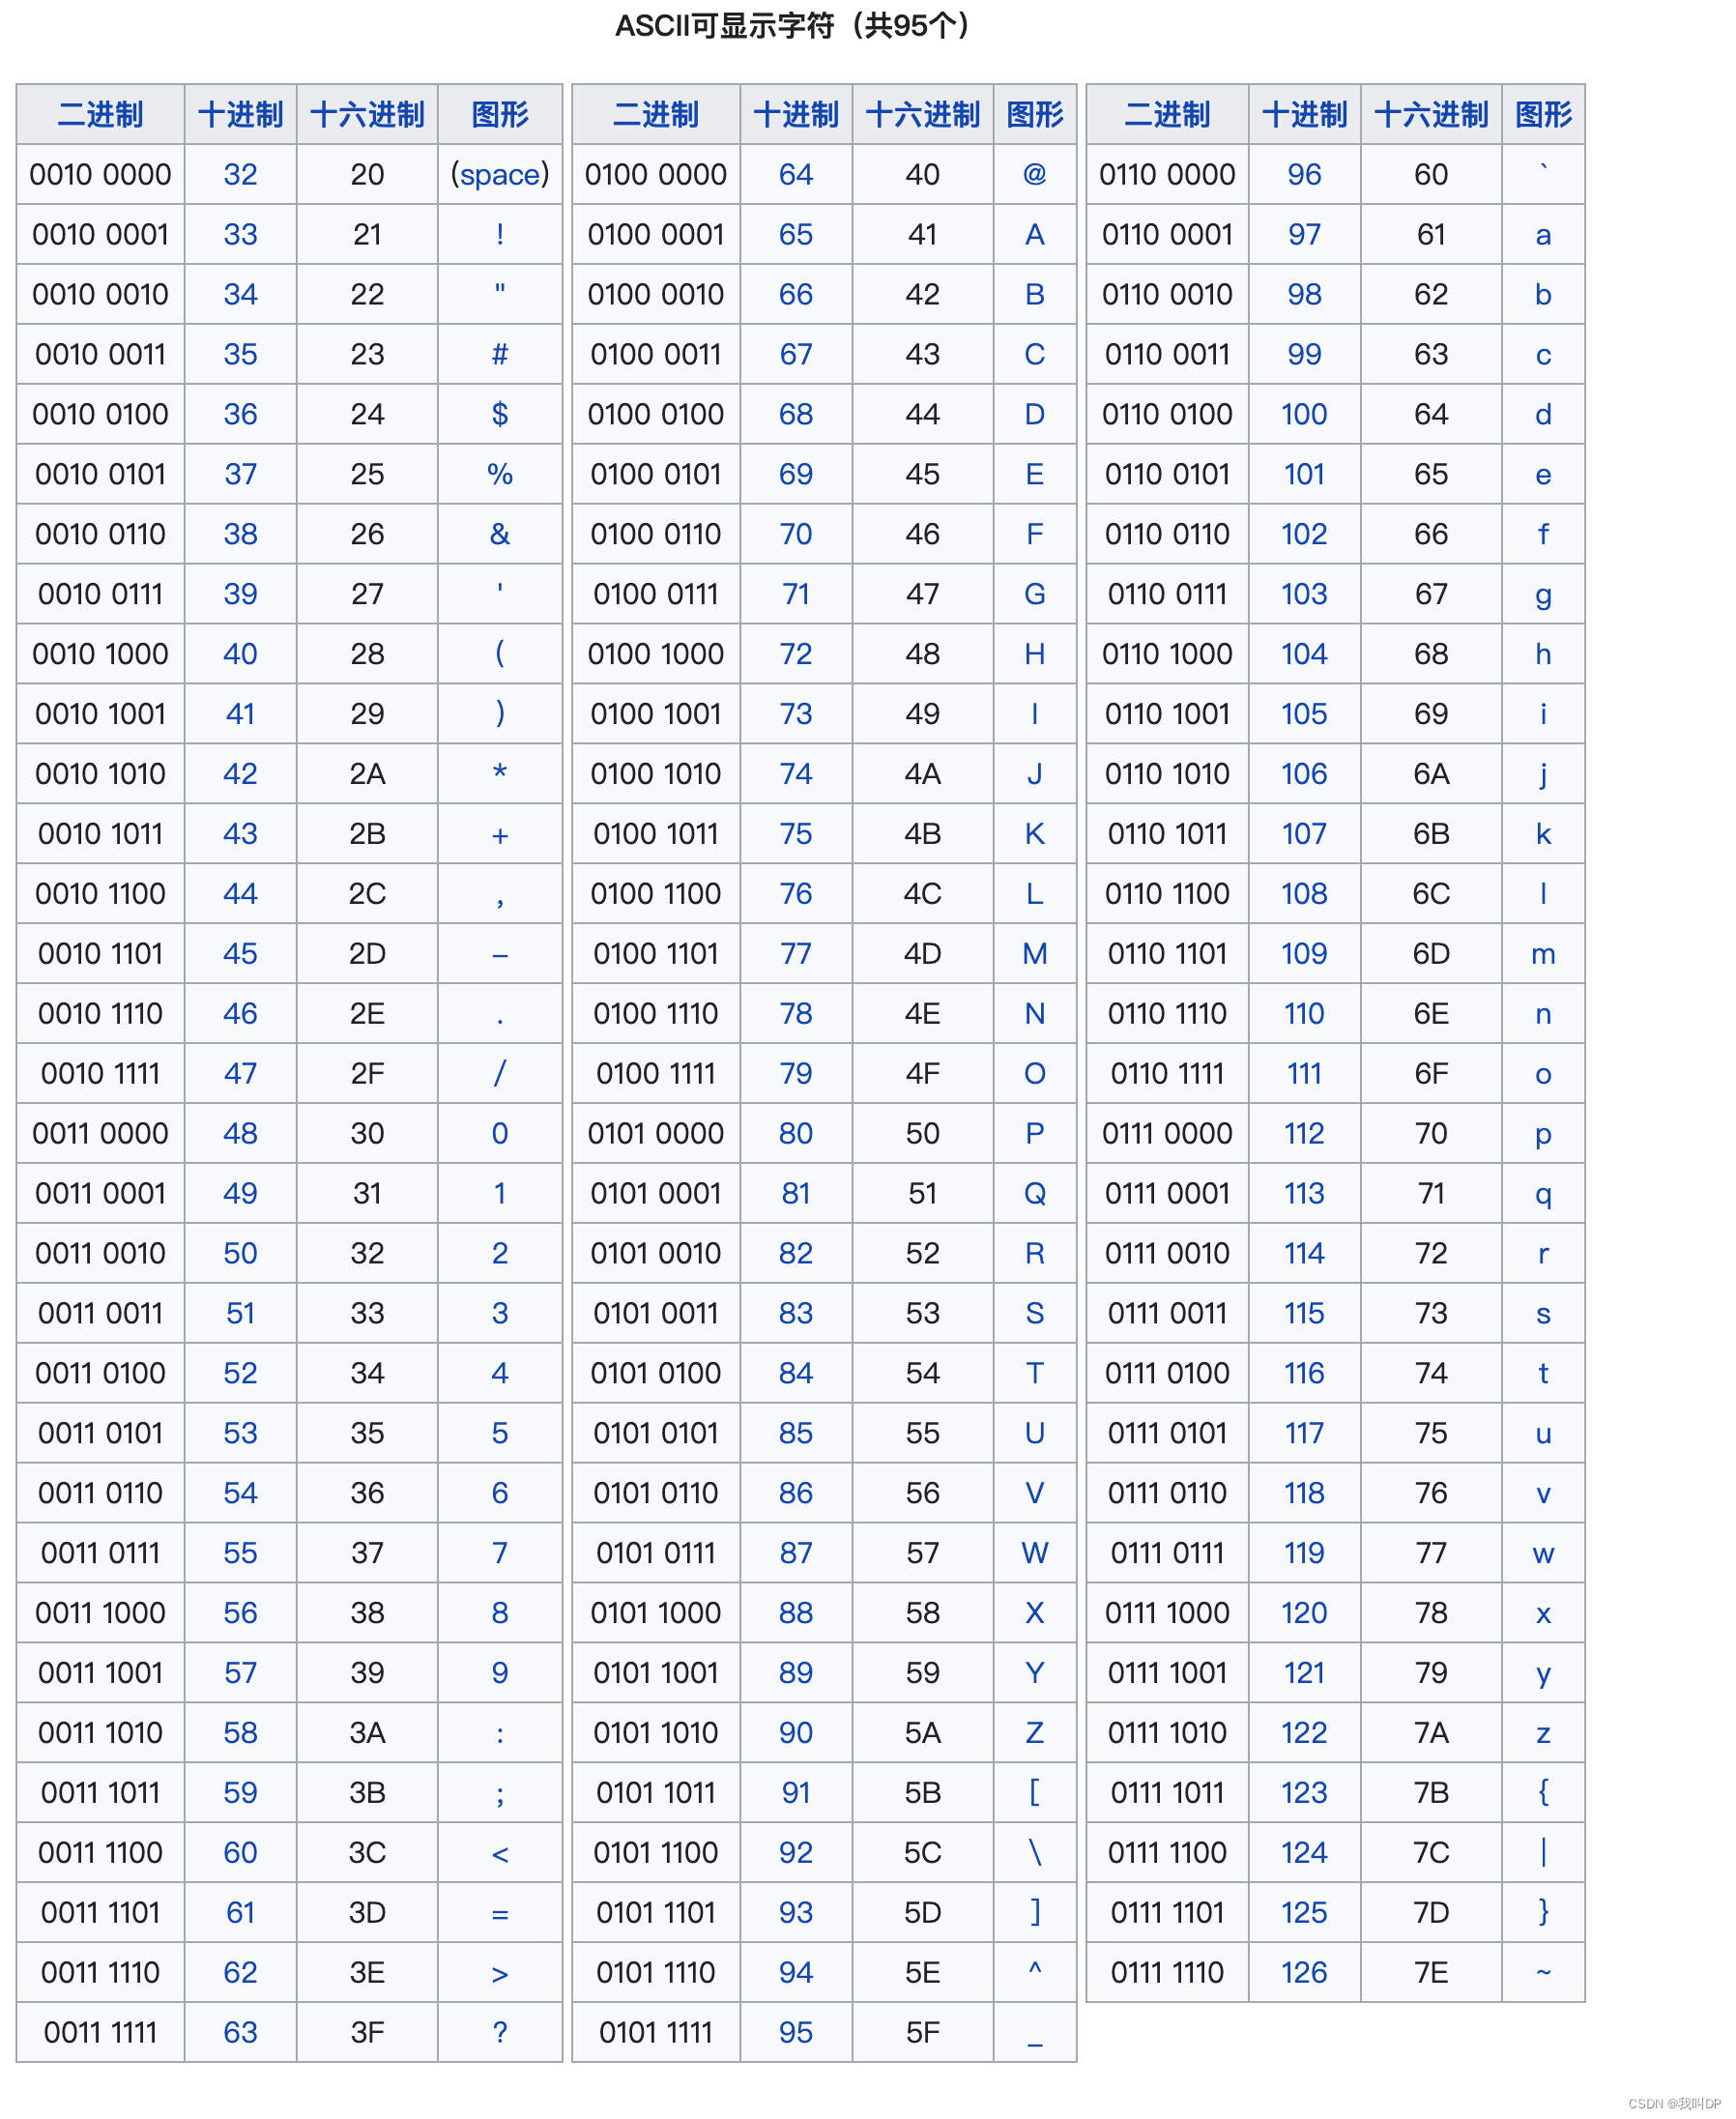
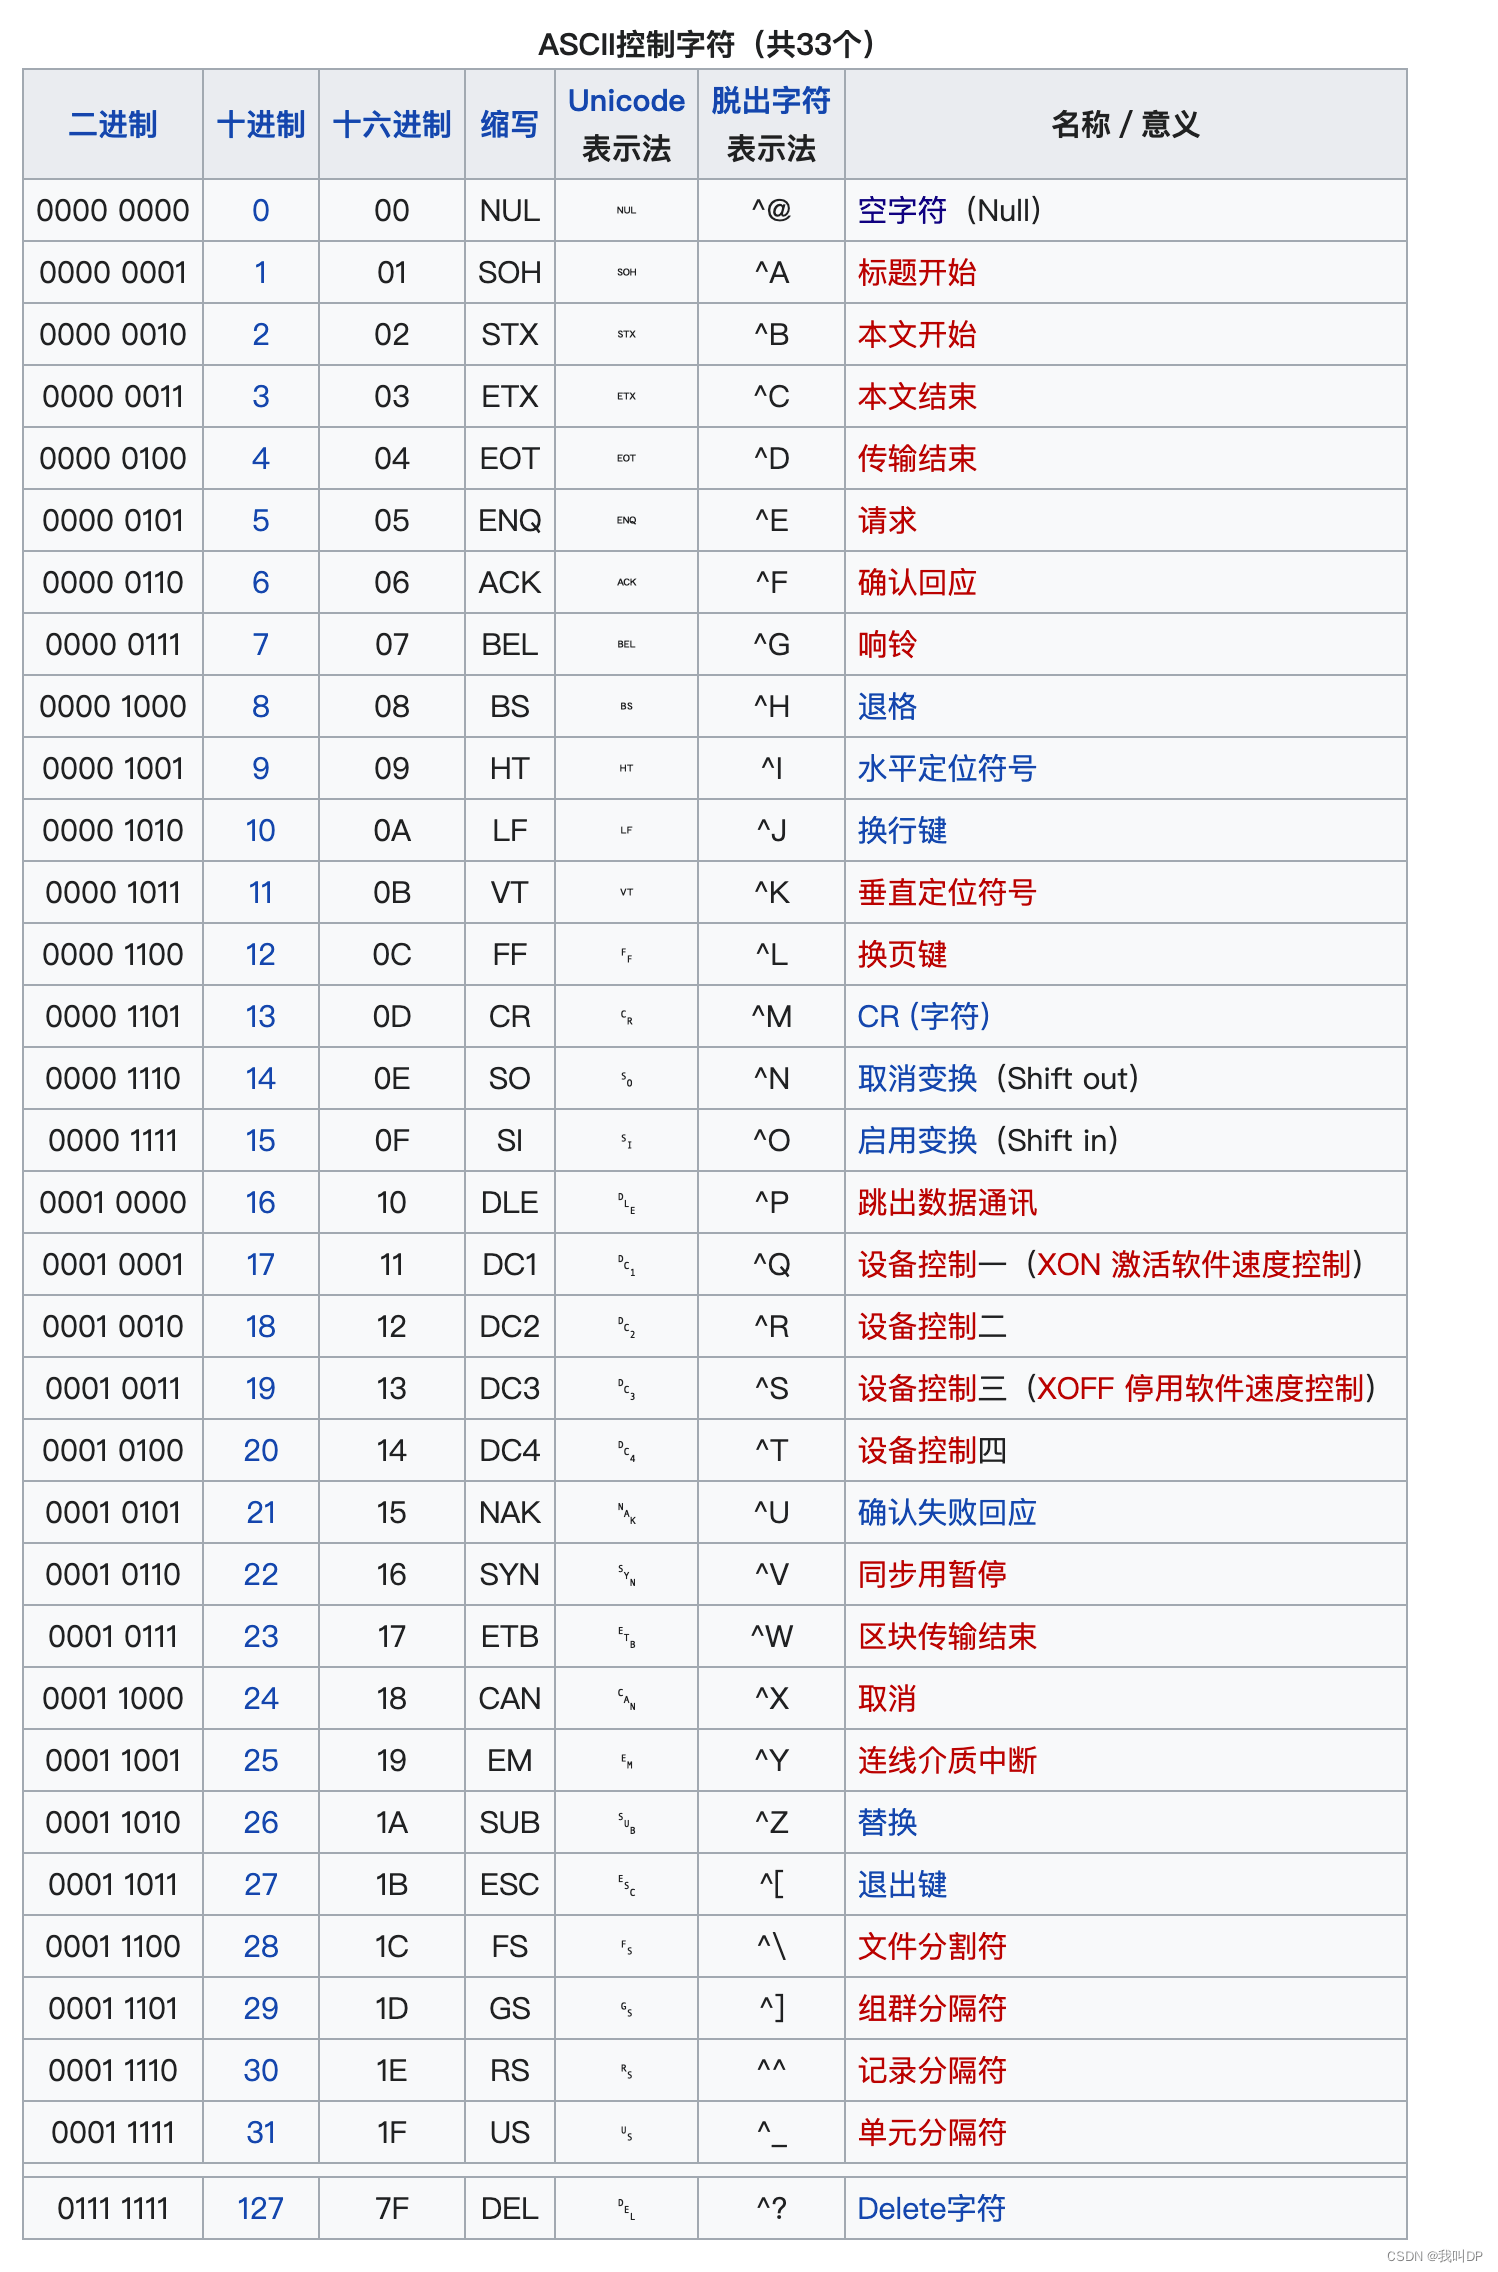
几个值得背下来的:'0' 是 48(0x30),'A' 是 65(0x41),'a' 是 97(0x61),大小写正好差 32;回车 \r 是 13,换行 \n 是 10。串口和 PLC 报文里经常能看到它们。
延伸
- C# 的
string是 UTF-16:"😀".Length等于 2,因为表情在 BMP 之外,要用一对代理。按「用户看到的字符」计数要用StringInfo或 .NET Core 3.0 起的Rune。 - .NET Core 默认不认识 GBK:先
Encoding.RegisterProvider(CodePagesEncodingProvider.Instance),再Encoding.GetEncoding("GBK")。.NET Framework 不需要这一步。 Encoding.UTF8写文件会带 BOM:老设备或别的语言程序读到开头的 EF BB BF 可能出错,用new UTF8Encoding(false)写无 BOM 的 UTF-8。- 中文 Windows 的「ANSI」就是 GBK(代码页 936):VS 里中文乱码,多半是源文件和编译器理解的编码不一致,见 VS 里中文乱码;数据库乱码见 上位机写数据库中文乱码。
原文首发于 blog.csdn.net