VS 里中文乱码:源文件的编码
2022 年 2 月 22 日 · 2 分钟读完
目录
移植项目时遇到的:代码在一台电脑上运行正常,放到另一台电脑上编译运行却出错。排查发现是代码里的中文字符串变成了乱码。
现象
中文字符串赋值后是乱码:
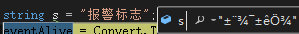
环境:VS2015,.NET Framework 4.7.2,C# 6.0。查看源文件的编码是 GB2312。
原因
源文件就是一串字节,编译器要先知道它是什么编码,才能把字节还原成字符。
- 文件开头有 BOM(UTF-8 的 BOM 是
EF BB BF)时,编译器据此判断编码,不会错; - 没有 BOM 时,编译器只能猜:先试 UTF-8,不像 UTF-8 的话就按这台电脑的系统默认编码(中文 Windows 是 GBK)去读。
GB2312 是没有 BOM 的。在中文系统上编译,按 GBK 读,刚好对;换到一台英文系统、或者开了「Beta 版:使用 Unicode UTF-8 提供全球语言支持」的电脑上,默认编码不是 GBK 了,中文就被读成了乱码,编译进程序里的字符串也就错了。
编码的原理见 字符编码:ASCII、GBK 与 Unicode。
解决:把源文件改成 UTF-8
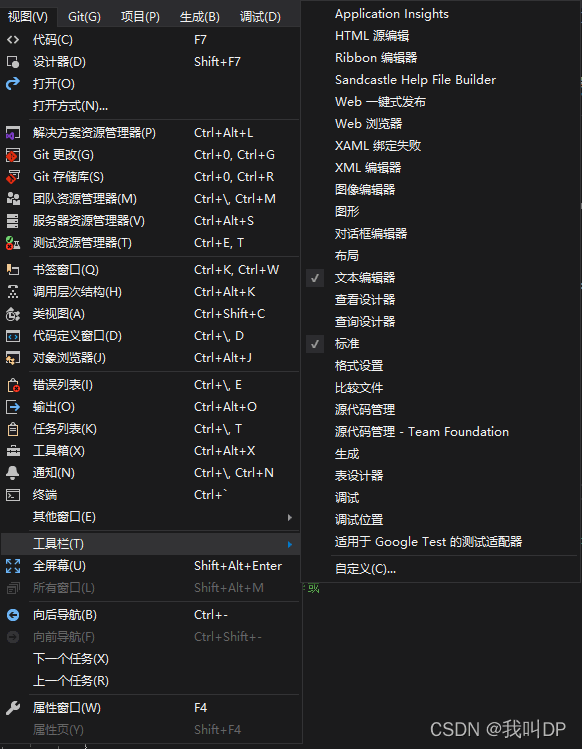
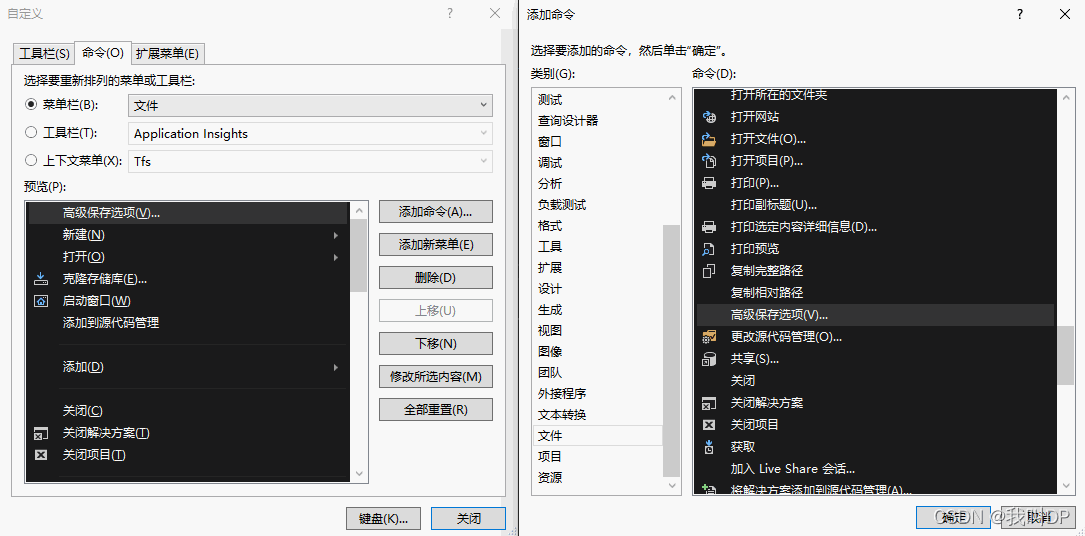
VS2015 的「高级保存选项」默认不在菜单里,要先加出来:
- 视图 → 工具栏 → 自定义:
- 命令 → 菜单栏选「文件」→ 添加命令 → 类别选「文件」→ 找到高级保存选项:
- 打开出问题的文件,文件 → 高级保存选项,编码选 Unicode (UTF-8 带签名) - 代码页 65001,保存:
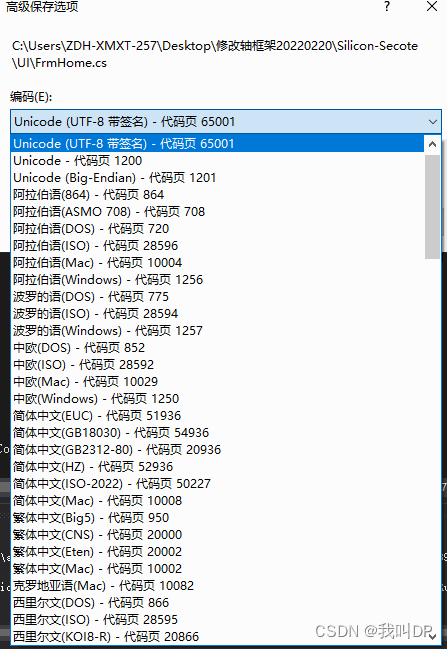
「带签名」就是带 BOM。之后不管在哪台电脑上编译都不会读错。
新版 VS2019 / 2022 里这个菜单默认是隐藏的,同样按上面的方法加出来;也可以「另存为」时点保存按钮旁边的小箭头 → 编码保存。
延伸
- 用 .editorconfig 一次管住整个项目:在解决方案根目录放一个
.editorconfig,VS 新建和保存文件时都会按它来:
root = true

[*.cs]
charset = utf-8-bom- 批量转换已有文件:文件多时一个个改太累。可以用 VS Code 打开文件夹,右下角点编码 → 通过编码保存;或者写个小脚本,按 GBK 读、按 UTF-8 带 BOM 写。转换前先提交一次 Git,万一转错了能回退。
- Git 里显示乱码:
git diff里中文显示成\346\210\221这种,是 Git 的路径转义,执行git config --global core.quotepath false;文件内容乱码则是编码不统一,同样统一成 UTF-8 解决。 - 运行时读写文件的乱码是另一回事:
File.ReadAllText默认按 UTF-8 读,读 GBK 文件要指定编码。.NET Core 以后要先Encoding.RegisterProvider(CodePagesEncodingProvider.Instance)才能用Encoding.GetEncoding("GBK")。数据库的中文乱码见 SQL 中文乱码。
原文首发于 blog.csdn.net